“Channels orchestrate; mutexes serialize.”
— Rob Pike, Go Proverbs (Gopherfest 2015)
Go Proverbs의 **“Channels orchestrate; mutexes serialize”**는 채널과 뮤텍스 중 무엇이 더 좋은지를 말하는 문장이 아니라, 두 도구가 애초에 서로 다른 축의 문제를 푼다는 사실을 말하는 문장이다.
뮤텍스(Mutex)는 하나의 메모리 위치에 여러 실행 흐름이 동시에 닿지 못하도록 접근을 한 줄로 세우는 도구이고, 채널(Channel)은 독립적으로 살아 움직이는 실행 흐름들이 언제 만나고 언제 헤어지며 언제 멈추는지를 설계하는 도구다.
지난 글에서는 공유 메모리의 문제가 결국 읽기-수정-쓰기의 비원자성 하나로 수렴한다는 점과, 접근을 직렬화하는 방법과 소유권을 설계하는 방법이 있다는 점을 살펴봤다.
이번 글에서는 위 두 가지 방법을 대표하는 도구인 뮤텍스와 채널을 더 깊게 파볼 것이다.
orchestrate와 serialize는 무엇이 다른가
직렬화(serialize)는 여러 실행 흐름이 하나의 자원에 접근하는 순서를 한 줄로 세워 동시 접근 자체를 없애는 것이고, 조율(orchestrate)은 독립적으로 진행하는 실행 흐름들이 서로 만나고 신호를 주고받는 시점을 설계하는 것이다.
에츠허르 다익스트라(Edsger Dijkstra)는 1965년 “Solution of a Problem in Concurrent Programming Control"에서 상호 배제(mutual exclusion) 문제를 정식화했다. 임계 영역에 한 번에 하나의 프로세스만 들어가게 하는 문제다. 반면 토니 호어(C. A. R. Hoare)가 1974년 “Monitors: An Operating System Structuring Concept"에서 모니터와 조건 변수(condition variable)를 제안한 이유는 상호 배제만으로는 버퍼가 비어있는지, 버퍼가 찼는지, 일이 끝났는지와 같은 조건을 기다리는 문제를 해결하기 어려웠다.
이를 각각 **상호 배제(mutual exclusion)와 조건 동기화(condition synchronization)**라고 부른다.
뮤텍스는 상호 배제만 제공하고, 채널은 데이터 전달과 실행 흐름을 하나로 묶는다. 그 결과 개발자는 공유 상태를 보호하기 위한 Mutex와 조건을 기다리기 위한 Condition Variable를 직접 작성하는 대신 데이터의 흐름 자체를 표현하는데 집중할 수 있다.
아래 예시를 통해 살펴보자.
Mutex + Condition Variable
이 방식은 공유 상태를 직접 관리하는 방식이다. Mutex는 공유 데이터에 대한 접근을 보호하고, Condition Variable은 데이터가 준비될 때까지 기다렸다가 깨우는 역할을 한다.
package main

import (
	"fmt"
	"sync"
)

var (
	mu    sync.Mutex
	cond  = sync.NewCond(&mu)

	ready bool
	value int
)

func producer() {
	mu.Lock()

	value = 42
	ready = true

	// 기다리는 소비자를 깨운다.
	cond.Signal()

	mu.Unlock()
}

func consumer() {
	mu.Lock()

	// 데이터가 준비될 때까지 기다린다.
	for !ready {
		cond.Wait()
	}

	v := value

	mu.Unlock()

	fmt.Println(v)
}

func main() {
	var wg sync.WaitGroup

	wg.Add(2)

	go func() {
		defer wg.Done()
		consumer()
	}()

	go func() {
		defer wg.Done()
		producer()
	}()

	wg.Wait()
}
여기서 개발자는 공유데이터(value), 준비 여부(ready), Mutex와 같이 직접 관리해야하는 포인트가 많다.
뮤텍스는 Lock이 반환됐다는 사실만 알려줄 뿐, 임계 영역(critical section)안에서 무엇을 읽어야 하는지, 왜 깨어났는지 등을 알려주지 않는다.
Channel
Mutex + Condition Variable로 구현한 코드를 채널로 구현하면 공유 상태가 사라진다.
package main

import (
	"fmt"
	"sync"
)

func producer(ch chan<- int) {
	ch <- 42
}

func consumer(ch <-chan int) {
	// 데이터가 올 때까지 기다린다.
	v := <-ch
	fmt.Println(v)
}

func main() {
	ch := make(chan int)

	var wg sync.WaitGroup

	wg.Add(2)

	go func() {
		defer wg.Done()
		consumer(ch)
	}()

	go func() {
		defer wg.Done()
		producer(ch)
	}()

	wg.Wait()
}
v := <-ch 코드는 값의 전달과 순서의 보장과 소유권의 이전을 동시에 수행한다.
채널을 사용한 방식은 Producer > Channel > Consumer라는 데이터 흐름이 명확히 표현된다.
이것이 Go Proverbs에서 말하는 **Channels orchestrate; mutexes serialize.**이다.
sync.Mutex는 어떻게 접근을 직렬화하는가
Go의 sync.Mutex는 하나의 32비트 정수(state)안에 락의 상태와 대기 정보를 비트 단위로 저장한다.
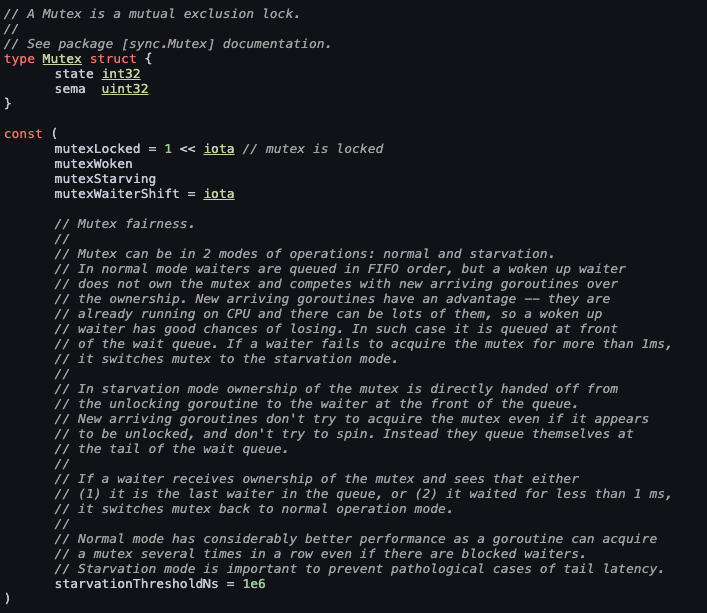
state의 가장 낮은 비트는 현재 락이 잡혀있는지(Locked), 그 다음 비트는 이미 대기 중인 goroutine을 깨웠는지(Woken), 그 다음 비트는 starvation mode 인지(Starving)
를 나타낸다. 나머지는 현재 락을 기다리는 goroutine의 개수가 저장된다.
31                                              3 2 1 0
+------------------------------------------------+-+-+-+
|              waiter count                      |S|W|L|
+------------------------------------------------+-+-+-+

L : Locked     (mutexLocked: 현재 락이 잡혀 있는가?)
W : Woken      (mutexWoken: 대기 중인 goroutine 하나가 이미 깨어났는가?, 중복 wake-up 방지)
S : Starving   (mutexStarving: Starvation Mode인가?)
나머지 비트 : waiter count (mutexWaiterShift: 대기 중인 goroutine 수)
락을 잡으면 mutexLocked 비트를 세우고, 기다리는 goroutine이 생기면 waiter count를 증가시키고,
starvation mode 면 mutexStarving 비트를 세우는 방식이다.
아래 Lock() 메서드를 살펴보자.
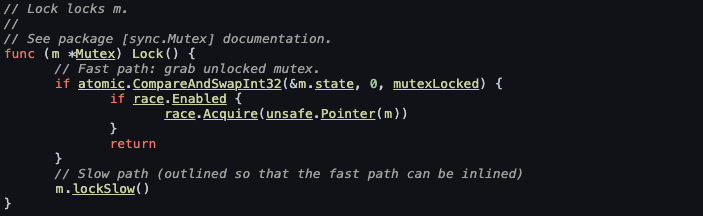
Fast Path를 보면 알 수 있듯이 아무것도 잡고 있지 않다면 CAS 한번으로 끝낸다. 즉, 경합이 없을 때 뮤텍스의 비용은 CAS 명령 하나다.
경합이 생기면 lockSlow()로 내려가는데, 여기서는 곧바로 고루틴을 재우지 않고 먼저 **스핀(spin)**을 시도한다. 락 보유 시간이 짧다면
잠깐 CPU를 태우며(스핀 하며) 기다리는 편이 스케줄링 비용(parking/unparking)보다 싸기 때문이다. 스핀 횟수는 런타임 상수로 정해져 있다.
// src/runtime/lock_spinbit.go
active_spin     = 4  // 최대 4회 스핀
active_spin_cnt = 30 // 1회당 30번의 PAUSE 계열 명령
4회를 넘겨도 락을 얻지 못하면 그때 세마포어를 통해 고루틴을 큐에 넣고 재운다. 스핀할 것인가 재울 것인가는 동시성 도구가 반복해서 마주치는 고전적인 트레이드오프이고, Go는 “아주 잠깐만 스핀하고 포기한다"는 지점을 선택했다.
여기서 중요한 점은 OS 스레드를 재우는 것이 아니로 고루틴을 park/unpark 하는 비용이다. Go 런타임은 고루틴만 대기 상태로 전환하고, 그 OS 스레드에는 다른 고루틴을 실행 시키므로 운영 체제 스레드를 블로킹 하는 것보다 저렴하다. 그럼에도 park/unpark 자체에도 대기열 관리, 스케줄러 작업, 컨텍스트 전환 등의 오버헤드가 있기 때문에, 아주 짧은 경합에서는 스핀하는 편이 낫다.
정리하면 Go 런타임은 CPU를 조금 더 사용하는 비용과 고루틴을 재웠다가 다시 깨우는 스케줄링 비용을 비교한다. 락이 곧 풀릴 것 같다면 잠시 스핀하는 것이 더 저렴하고, 경합이 길어질 것 같다면 고루틴을 재워 CPU를 다른 작업에 사용하도록 한다.
Mutex의 두 가지 모드 - normal, starvation
Go sync.Mutex는 항상 공정한 락(Fair Lock)을 사용하지 않고 상황에 따라 두 가지 모드를 사용한다.
핵심은 다음과 같다.
Mutex는 평소에는 처리량(throughput)을 우선하고, 특정 고루틴이 너무 오래 기다리면 공정성을 우선한다.
위 Mutex 이미지에서 starvationThresholdNs 관련 주석에 두 가지 모드에 대해 자세히 명시되어있다.
“Normal mode has considerably better performance … Starvation mode is important to prevent pathological cases of tail latency.”
정상 모드(normal mode)에서는 깨어난 대기자가 락의 소유권을 자동으로 받지 못하고, 방금 도착한 고루틴들과 다시 경쟁해야 한다. 이때 새로 도착한 고루틴은 이미 CPU 위에서 돌고 있으므로 압도적으로 유리하고, 깨어난 대기자는 번번이 진다. 이런 새치지를 바징(barging)이라고 부른다. 바징은 기다리고 있던 스레드보다 새로 들어온 스레드가 먼저 락을 획득하는 현상을 말한다. 바징은 처리량 관점에서는 이득이다. 이미 실행 중인 고루틴이 락을 빠르게 다시 획득하면 스케줄링 비용이 줄고, 전체 처리량이 올라간다. 문제는 대기하고 있는 특정 고루틴이 무한정 밀릴 수 있다는 것이다. 이것이 기아(starvation)이다.
그래서 Go는 어떤 대기자가 1밀리초(starvationThresholdNs = 1e6) 넘게 락을 얻지 못하면 뮤텍스를 기아 모드로 전환한다.
기아 모드에서는 Unlock()이 락 소유권을 대기열 맨 앞의 고루틴에게 직접 넘겨주고, 새 고루틴은 normal mode처럼 빠른 CAS 획득을 시도하지 않고
waiter queue 뒤에 추가된다. 대기 시간이 1ms 미만으로 떨어지거나 대기열이 비면 다시 정상 모드로 돌아온다.
채널은 어떻게 실행 흐름을 조율하는가
Go의 채널은 링 버퍼와 두 개의 고루틴 대기열, 그리고 그것들을 보호하는 뮤텍스로 이루어진 런타임 자료구조이며, 값의 전달과 실행 순서의 보장을 하나의 연산으로 묶어 제공한다.
// src/runtime/chan.go
type hchan struct {
	qcount   uint           // 버퍼에 들어있는 원소 수
	dataqsiz uint           // 버퍼 용량 — make(chan T, n)의 n
	buf      unsafe.Pointer // 원형 큐
	sendx    uint           // 다음에 쓸 위치
	recvx    uint           // 다음에 읽을 위치
	recvq    waitq          // 수신을 기다리며 잠든 고루틴들
	sendq    waitq          // 송신을 기다리며 잠든 고루틴들
	lock     mutex          // 위 필드 전부를 보호한다
}
주목할 필드는 마지막 줄이다. 채널의 내부에는 뮤텍스가 있다. 채널은 뮤텍스를 대체하는 도구가 아니라, 뮤텍스 위에 대기열과 스케줄러 연동을 얹어 만든 상위 계층이다. 그래서 채널이 뮤텍스보다 쌀 수가 없다. 채널 연산 한 번은 최소한 뮤텍스 연산 한 번을 포함한다.
recvq와 sendq에 들어가는 원소는 sudog라는 구조체인데, 이것이 “어떤 고루틴이 기다리고 있고, 송수신할 데이터 위치는 어디인지, 어떤 채널에서 기다리는지"를 표현한다.
여기서 unbuffered channel의 중요한 최적화가 나온다.
송신자가 값을 보내려고 할 때 이미 recvq에 수신 대기 중인 고루틴이 있다면, 런타임은 값을 채널 내부에 저장했다가 다시 꺼내지 않는다.
대신 송신자가 가진 데이터를 수신자가 제공한 목적지 주소로 직접 복사하고, 기다리던 고루틴을 바로 실행 가능한 상태로 만든다.
그리고 이 모든 과정에서 Go 메모리 모델이 보장하는 순서 관계가 함께 성립한다. 채널 송신은 대응하는 수신의 완료보다 먼저 일어나고(happens-before), 채널 닫기는 닫힘을 관찰하는 모든 수신보다 먼저 일어난다.
Go 동시성 프리미티브 벤치마크 리포트
이 글의 모든 수치를 한 화면에 모은 대시보드다. 무경합과 14코어 경합의 지연을 같은 로그 스케일 위에 나란히 놓고,
채널 버퍼 크기가 백프레셔에 어떤 영향을 주는지, 거짓 공유가 CPU 캐시 라인 수준에서 왜 발생하는지,
select가 정말 무작위로 케이스를 고르는지까지 측정값과 함께 보여준다. 각 점과 막대에 마우스를 올리면 정확한 값이 나온다.
무경합 지연 — 단일 고루틴
경합이 없을 때 각 프리미티브 1회 왕복 비용. 값의 범위가 3자릿수를 넘어 x축은 로그 스케일이며, 막대 길이 대신 점의 위치로 값을 나타낸다.
경합 지연 — 14코어가 하나의 상태를 두고 경쟁
b.RunParallel 로 14개 코어가 동시에 같은 상태를 갱신할 때의 1회 비용. 같은 로그 스케일. 여기서의 ns/op 은 지연이 아니라 처리량을 연산당으로 환산한 값이다.
채널 버퍼 크기 = 백프레셔 정책
같은 소유자 고루틴 패턴에서 버퍼 크기만 바꿨을 때의 지연.
거짓 공유 — 논리적으로 무관한 두 변수
두 고루틴이 각각 다른 atomic.Int64 를 증가시킨다. 공유하는 상태는 없다.
왜 거짓 공유가 생기는가 — CPU 캐시 라인과 무효화
위 4.8배가 어디서 왔는지를 CPU 캐시 관점에서 단계별로 따라간다. 이 문제는 mutex·atomic·channel 보다 한 층 아래, 메모리가 물리적으로 어떻게 배치되는가의 문제다.
counterA 와 counterB 는 서로 다른 변수다. 아무도 같은 값을 건드리지 않으니 락도 필요 없고, 병렬로 돌리면 그만큼 빨라져야 한다.1. CPU 는 변수 단위가 아니라 64바이트 캐시 라인 단위로 읽는다
메모리에서 8바이트짜리 카운터 하나만 가져오는 일은 없다. CPU 는 언제나 캐시 라인 하나를 통째로 캐시에 올린다. 그래서 변수를 나란히 선언하면 같은 라인에 담긴다.
8.071 ns1.668 ns2. 한쪽이 쓰면 다른 쪽 캐시가 통째로 무효화된다
멀티코어 CPU 는 코어마다 캐시 사본을 갖고, MESI 계열 프로토콜로 일관성을 유지한다. 어떤 코어가 라인에 쓰기를 하려면 그 라인을 독점해야 하고, 다른 코어가 갖고 있던 사본은 무효화(invalidate)된다. 문제는 무효화의 단위가 변수가 아니라 라인 전체라는 점이다.
- STEP 1 · 시작Core 1 ● 유효Core 2 ● 유효두 코어가 같은 라인의 사본을 각자 들고 있다. 여기까지는 아무 비용도 없다.
- STEP 2 · Core 1 쓰기Core 1 ✎ 수정Core 2 ✕ 무효
counterA.Add(1). Core 2 는 counterB 만 쓰는데도 사본 전체를 버려야 한다. - STEP 3 · Core 2 쓰기Core 1 ✕ 무효Core 2 ✎ 수정
counterB.Add(1). Core 2 는 라인을 다시 가져와야 하고, 이번엔 Core 1 사본이 죽는다. - STEP 4 · 반복Core 1 ✕ 무효Core 2 ✕ 무효라인 하나가 코어 사이를 끝없이 왕복한다. 병렬로 돌린 두 루프가 사실상 직렬화된다.
3. 그래서 패딩을 넣는다 — 왜 하필 56바이트인가
해결책은 두 변수를 서로 다른 캐시 라인으로 밀어내는 것이다. 변수 뒤에 빈 공간을 채워 라인 하나를 통째로 점유하게 만든다.
캐시 라인      64 bytes
atomic.Int64  -  8 bytes
              ─────────────
패딩          = 56 bytes
Go 에서는 익명 필드로 표현한다. 이름이 _ 라서 아무도 읽지 않지만, 메모리를 차지하는 것 자체가 목적이다.
type paddedCounter struct {
    n atomic.Int64
    _ [56]byte   // 8 + 56 = 64 — 라인 하나를 혼자 쓴다
}select 는 준비된 케이스를 무작위로 고른다
두 채널을 각각 1,000개의 값으로 가득 채운 뒤 select 를 1,000회 실행하고, 어느 케이스가 선택됐는지 셌다. 3회 반복.
case <-ctx.Done(): 를 맨 위에 쓴다고 먼저 검사되지 않는다. 우선순위가 필요하면 중첩 select 와 default 로 명시해야 한다.전체 측정값 (table view)
모든 차트의 원본 데이터. 3회 샘플과 중앙값, 단위 ns/op.
| 벤치마크 | 조건 | #1 | #2 | #3 | 중앙값 |
|---|
측정 환경 Apple M4 Pro (Mac16,11) · macOS · Go 1.26.5 darwin/arm64 — GOMAXPROCS=14.
ns/op 은 반복 1회당 평균 소요 시간이며, 절대값은 하드웨어에 따라 달라진다. 이 리포트가 말하는 것은 절대값이 아니라 프리미티브 사이의 상대 비율이다.
버퍼를 0으로 줄이면 272.3 ns로, 뮤텍스보다 2.5배 느려진다. 채널이 경합 상황에서 뮤텍스보다 빨랐다면 그 이득은 채널이 아니라 버퍼가 만들어낸 것이며, 버퍼는 처리량을 사는 대신 지연을 숨긴다.
경합을 구조적으로 없애면 어떻게 되는지도 위 표에 있다. 코어별로 카운터를 쪼개고 캐시 라인 패딩을 준 샤딩 방식은 0.280 ns/op로, 단일 원자 카운터(53.28 ns) 대비 약 190배 빨랐다. (이 항목은 값 자체가 작아 실행별 편차가 큰 편이라, 반복 측정에서는 160~190배 범위로 나온다. 정확한 상수가 아니라 자릿수로 읽는 편이 맞다.) Go 런타임과 표준 라이브러리가 sync.Pool의 per-P 캐시, sync.Map의 read/dirty 분리, 메모리 할당자의 mcache처럼 곳곳에서 이 전략을 쓰는 이유가 여기에 있다. 경합하는 락을 최적화하는 가장 좋은 방법은 대개 락을 더 빠르게 만드는 것이 아니라, 경합할 이유를 없애도록 상태를 쪼개는 것이다.
select - 뮤텍스에는 존재하지 않는 연산
select는 여러 채널 연산 중 준비된 것 하나를 무작위로 골라 실행하고, 아무것도 준비되지 않았으면 모든 채널의 대기열에 동시에 등록한 뒤 잠드는 연산이며, 뮤텍스에는 이에 대응하는 연산이 아예 존재하지 않는다.
이 문장이 이번 글의 proverb를 잘 설명한다. 상호 배제라는 추상화에는 애초에 “여러 사건 중 하나를 기다린다"는 개념이 들어 있지 않다. 바로 이 지점에서 뮤텍스는 serialize에 머물고 채널은 orchestrate로 넘어간다.
runtime.selectgo의 구현을 보면 select가 두 개의 순서 배열을 만드는 것을 볼 수 있다.
// src/runtime/select.go
pollorder := order1[:ncases:ncases]      // 어떤 순서로 케이스를 검사할 것인가
lockorder := order1[ncases:][:ncases:ncases] // 어떤 순서로 채널을 잠글 것인가
두 배열은 정반대의 목적을 갖는다.
lockorder는 채널의 메모리 주소를 기준으로 정렬된다(소스에서는 힙 정렬로 sortkey() 순서를 만든다). select는 여러 채널의 락을 동시에 쥐어야 하는데, 두 고루틴이 서로 다른 순서로 같은 채널 두 개를 잠그면 그 자체로 데드락이 된다.
이것은 운영체제 교과서가 데드락 예방 기법으로 가르치는 **자원에 전역 순서를 부여하기(ordered resource allocation)**를 언어 런타임이 그대로 구현한 사례다. 개발자가 select 케이스를 어떤 순서로 쓰든, 런타임은 항상 주소 오름차순으로 잠근다.
pollorder는 반대로 Fisher-Yates 셔플로 무작위화된다.
// src/runtime/select.go
j := cheaprandn(uint32(norder + 1))
pollorder[norder] = pollorder[j]
pollorder[j] = uint16(i)
이유는 공정성이다. 만약 select가 항상 첫 번째 케이스부터 검사한다면, 두 채널이 모두 계속 준비된 상황에서 아래쪽 케이스는 영원히 선택되지 않는다. 기아가 언어 문법 수준에서 발생하는 셈이다. 실제로 그런지 확인해봤다. 두 채널을 각각 1000개의 값으로 가득 채운 뒤 select를 1000번 실행하고 어느 케이스가 선택됐는지 세었다.
SELECT-FAIRNESS: first-case=523 second-case=477
SELECT-FAIRNESS: first-case=494 second-case=506
SELECT-FAIRNESS: first-case=505 second-case=495
세 번 모두 50 대 50에 수렴한다. 균등 분포다. select 문에서 케이스를 쓰는 순서는 우선순위가 아니며, 준비된 케이스가 여럿이면 Go 런타임은 그중 하나를 균등한 확률로 무작위 선택한다.
이는 실무에서 자주 오해되는 지점이다. “종료 신호를 먼저 확인하도록 case <-ctx.Done():을 맨 위에 쓴다"는 코드는 의도대로 동작하지 않는다. 작업 채널에도 값이 있다면 절반의 확률로 작업이 먼저 처리된다. 우선순위가 필요하면 중첩 select와 default로 명시적으로 표현해야 한다.
아무 케이스도 준비되지 않았을 때의 동작은 더 인상적이다. select는 모든 채널의 대기열에 자기 자신을 sudog로 등록한 뒤 한 번 잠들고, 어느 채널에서든 깨어나면 나머지 모든 대기열에서 자신을 제거한다.
하나의 고루틴이 N개의 사건을 동시에 기다리는 이 구조가, 뮤텍스로는 흉내 낼 수 없는 조율 능력의 실체다.
채널만이 답할 수 있는 질문들 - 취소, 타임아웃, 백프레셔
취소(cancellation), 타임아웃(timeout), 백프레셔(backpressure)는 모두 “언제 진행하고 언제 멈출 것인가"라는 시간 축의 문제이며, 상호 배제만 제공하는 뮤텍스로는 표현 자체가 불가능하다.
취소는 브로드캐스트다
닫힌 채널에서의 수신은 즉시, 그리고 몇 번이든 성공한다. 이 성질 하나로 채널은 1:N 브로드캐스트 신호가 된다.
done := make(chan struct{})

for i := 0; i < 100; i++ {
	go worker(done) // 100개의 고루틴이 같은 채널을 바라본다
}

close(done) // 단 한 번의 close로 100개 전부에게 동시에 신호가 간다
context.Context가 하는 일의 본질이 정확히 이것이다. ctx.Done()은 채널을 반환하고, 취소는 그 채널을 닫는 동작이며, 부모 컨텍스트의 취소가 자식들에게 전파되는 것도 닫힌 채널의 관찰 가능성이 전파되는 것이다.
같은 일을 뮤텍스로 하려면 취소 플래그를 락으로 보호하고 모든 고루틴이 주기적으로 그것을 폴링해야 한다. 폴링 주기만큼 반응이 늦고, 블로킹 중인 고루틴은 폴링조차 못 한다.
타임아웃은 케이스 하나다
select {
case res := <-resultCh:
	return res, nil
case <-time.After(500 * time.Millisecond):
	return nil, errors.New("timeout")
}
sync.Mutex에는 TryLock()은 있어도(Go 1.18+) “500ms 동안만 기다린다"는 연산이 없다. 표준 라이브러리 문서가 TryLock에 대해 남긴 경고도 인상적이다.
“correct uses of TryLock do exist, they are rare, and use of TryLock is often a sign of a deeper problem”
시간을 다루려는 시도가 뮤텍스 위에서 나타나면, 그것은 대개 도구를 잘못 골랐다는 신호다.
버퍼 크기는 백프레셔 정책이다
Go 채널을 사용할 때 버퍼 크기를 단순히 “성능을 높이기 위한 숫자"로 생각하기 쉽다. 하지만 채널의 버퍼 크기는 더 근본적인 설계 결정이다.
채널 버퍼 크기는 소비자가 처리하지 못하는 상황에서 시스템이 얼마나 많은 작업을 메모리에 쌓아둘 것인지 결정하는 값이다.
즉, 버퍼의 크기는 처리량만 결정하는 것이 아니라 시스템이 허용하는 대기 작업량과 백프레셔(backpressure)가 시작되는 지점을 결정한다.
큐잉 이론의 리틀의 법칙(Little’s Law)은 이 관계를 설명하는 데 도움을 준다.
L = λW
L: 시스템 안에 평균적으로 존재하는 작업 수λ: 작업이 들어오는 속도W: 작업이 머무는 평균 시간
채널 버퍼는 L의 평균값을 직접 결정하는 것은 아니지만, 시스템이 허용할 수 있는 **대기 작업량의 상한(capacity)**을 정한다.
예를 들어 아래 코드는 단순히 “성능을 위해 100개를 저장한다"는 의미가 아니다.
jobs := make(chan Job, 100)
정확히는 “소비자가 잠시 느려지더라도 최대 100개의 작업까지는 생산자가 계속 진행할 수 있도록 허용한다"라는 시스템 정책이다.
생산자가 빠르고 소비자가 느린 상황에서도 버퍼가 있으면 생산자는 일정 시간 동안 계속 진행할 수 있다.
하지만 중요한 점은 버퍼가 문제를 제거하는 것이 아니라 뒤로 미룬다는 것이다.
버퍼가 크면 처리량은 좋아질 수 있고, 생산자는 더 오래 멈추지 않으며 순간적인 부하를 흡수할 수 있다. 대신 단점으로는 메모리 사용량 증가, 작업 처리 지연 증가, 장애 발생 시 더 많은 미처리 작업 손실 가능성이 있다.
채널로 뮤텍스를 대체하면 무엇이 나빠지는가
단순한 공유 상태를 보호하려고 채널과 전용 고루틴을 도입하면, 상호 배제 하나를 해결하는 대가로 고루틴 생명주기 관리라는 더 어려운 문제를 새로 떠안게 된다.
지난 글에 나온 stockKeeper 같은 소유자 고루틴 패턴은 강력하지만, 단순히 맵 하나를 보호하는 용도로 쓰면 다음 문제들이 새로 생긴다.
// 안티패턴 — 카운터 하나를 위해 고루틴과 채널 세 개를 도입한다
type Counter struct {
	incCh   chan int
	getCh   chan chan int
	closeCh chan struct{}
}
- 고루틴 누수(goroutine leak) — 소유자 고루틴을 누가 언제 종료시키는가. 종료를 잊으면 프로세스가 살아있는 내내 남는다. 뮤텍스로 보호한 필드에는 애초에 종료할 대상이 없다.
- 응답 채널 관리 — 값을 읽어오려면 요청마다 reply 채널을 만들어 실어 보내야 한다. 위 실측에서 채널 왕복은 100 ns 대이고, 뮤텍스로 읽으면 1.6 ns 대다.
- 에러와 패닉 전파 — 소유자 고루틴 안에서 패닉이 나면 프로세스 전체가 죽거나,
recover로 살려도 그 뒤로 모든 요청이 영원히 블로킹된다. 뮤텍스는defer mu.Unlock()한 줄로 패닉 안전성을 얻는다. - 디버깅 난이도 — 뮤텍스로 보호된 임계 영역은 코드가 물리적으로 인접해 있어 눈으로 읽을 수 있다. 채널로 흩어놓으면 스택 트레이스가 “채널에서 대기 중"까지만 알려준다.
반대 방향의 실수도 똑같이 흔하다. 조율 문제를 뮤텍스와 sync.Cond로 풀려는 시도는 조건 변수의 고전적 함정을 전부 다시 만난다. 대기 전에 조건을 검사하고 잠드는 사이의 틈에서 신호를 놓치는 잃어버린 깨움(lost wakeup), 그래서 Wait()를 반드시 for 루프로 감싸야 한다는 규칙, Signal과 Broadcast 중 무엇을 써야 하는지의 판단 같은 것들이다.
Go 팀이 sync.Cond를 거의 홍보하지 않고 대부분의 문서에서 채널을 권하는 이유가 여기에 있다.
그래서 언제 무엇을 쓰는가
보호하려는 대상이 특정 자료구조의 상태라면 뮤텍스를, 설계하려는 대상이 실행 흐름들 사이의 시점과 데이터의 이동이라면 채널을 쓴다.
실전에서 잘 설계된 Go 프로그램은 채널과 뮤텍스 중 하나를 고르지 않고, 바깥 계층의 흐름 제어는 채널로, 안쪽 계층의 상태 보호는 뮤텍스로 나누어 쓴다.
표준 라이브러리 자체가 이 구조를 따른다. net/http의 Server는 연결마다 고루틴을 띄우고 종료·취소는 채널과 컨텍스트로 조율하지만, 서버 내부의 활성 연결 집합이나 상태 맵은 평범한 sync.Mutex로 보호한다.
아래 계층 분리가된 예제를 살펴보자.
// Metrics는 여러 워커가 갱신하는 집계 상태다 — 뮤텍스로 보호한다.
type Metrics struct {
	mu       sync.Mutex
	success  int
	failure  int
}

func (m *Metrics) Record(ok bool) {
	m.mu.Lock()
	defer m.mu.Unlock() // 패닉이 나도 반드시 풀린다
	if ok {
		m.success++
	} else {
		m.failure++
	}
}

// Run은 작업의 흐름을 다룬다 — 채널로 조율한다.
func Run(ctx context.Context, jobs []Job, workers int) *Metrics {
	jobCh := make(chan Job)      // 버퍼 없음 = 워커가 소화하는 만큼만 생산한다
	metrics := &Metrics{}

	var wg sync.WaitGroup
	for i := 0; i < workers; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			for job := range jobCh { // 채널이 닫히면 자연스럽게 종료된다
				metrics.Record(process(job)) // 안쪽은 뮤텍스 — 1.6 ns로 끝난다
			}
		}()
	}

	// 생산자: 취소 신호와 작업 전달 중 먼저 오는 것을 기다린다
	go func() {
		defer close(jobCh) // 종료 책임의 소재를 한 곳으로 모은다
		for _, job := range jobs {
			select {
			case jobCh <- job:
			case <-ctx.Done(): // 취소되면 즉시 생산을 멈춘다
				return
			}
		}
	}()

	wg.Wait()
	return metrics
}
이 코드에서 채널과 뮤텍스는 경쟁하지 않는다. 각자 자기 층위의 문제만 푼다.
작업이 어떻게 흐르고 언제 멈추는지는 jobCh와 select와 ctx.Done()이 표현하고, 카운터 두 개가 안전하게 증가하는지는 Metrics.mu가 책임진다.
맺음말
Go에서 좋은 동시성 설계는 채널과 뮤텍스 중 하나를 선택하는 일이 아니라, 조율해야 할 것과 직렬화해야 할 것을 정확히 구분해 각각을 올바른 층위에 배치하는 일이다.